OCI Supercluster 預計 2025 年上半年推出,規模可擴充到使用 13 萬多顆「Blackwell」GPU,提供峰值可達 2.4 zettaflops 的人工智慧算力。
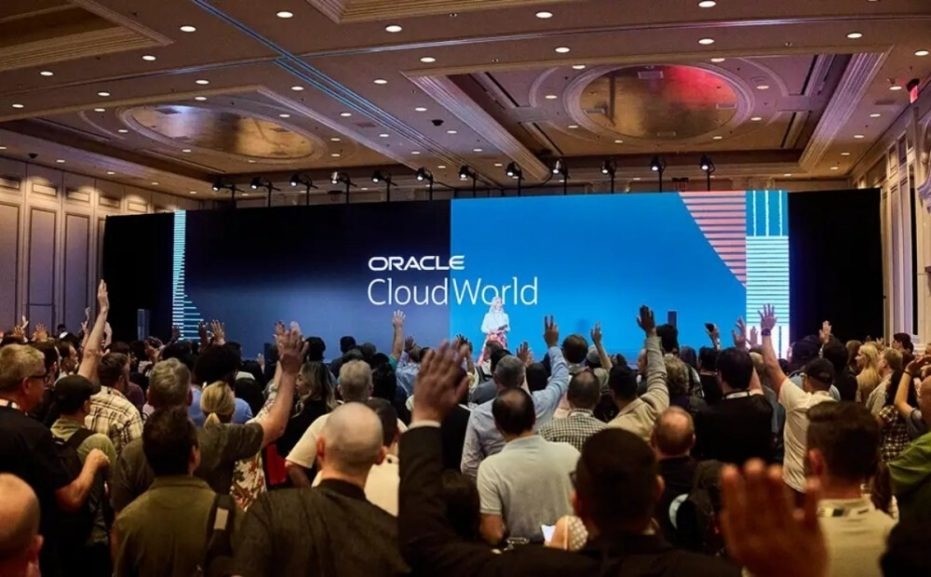
在甲骨文舉辦的Oracle Cloud World大會中,NVIDIA宣布與甲骨文合作建構Zetta級別規模的運算叢集OCI Supercluster,其中以NVIDIA新一代「Blackwell」加速運算平台支撐,並且讓企業能以最新GPU加速技術訓練、佈署下一代人工智慧模型。
OCI Supercluster可對應多種NVIDIA GPU加速產品,並且能部署於內部、公有雲或主權雲端,而以「Blackwell」架構建立的OCI Supercluster運算叢集將於2025年上半年推出,規模可擴充到使用13萬1072顆「Blackwell」GPU,搭配適用於RoCE v2網路層協定的NVIDIA ConnectX-7 NIC,或是NVIDIA Quantum-2 InfiniBand網路,藉此在雲端環境提供峰值可達2.4 zettaflops的人工智慧算力。
另外,甲骨文也在大會上展示以NVIDIA GB200 NVL72打造的液冷裸機執行個體,藉此對應各類自動生成式人工智慧執行應用,並且能透過NVIDIA Quantum-2 InfiniBand網路進行大規模訓練,同時配合NVLink技術串聯形成更大型GPU。
而甲骨文計畫在今年內提供以NVIDIA HGX H200建構的OCI運算叢集,透過NVLink與NVLink Switch技術在單一裸機執行個體裡連接8個NVIDIA H200 GPU,並且在 RoCE v2網路層協定叢集網路以NVIDIA ConnectX-7 NIC,將運算叢集擴充至6萬5536個H200 GPU。
針對離線裝置或處於遠端地點的邊緣運算需求,甲骨文也藉由NVIDIA GPU加速、具擴充特性佈署人工智慧運算能力,其中包含以Roving Edge Device v2進行的小規模邊緣運算部署,最多可支援三個NVIDIA L4 Tensor核心 GPU作為加速運算。
至於政府及企業資料駐留需求,甲骨文也與NVIDIA合作提供全球主權人工智慧基礎架構,藉此確保各類運算的資料主權特性,並且符合在地法規。